7 文件和数据格式化

7.1 文件的类型

  • 文件时存储在辅助存储器上的数据序列
  • 文件展现形态:文本文件和二进制文件
  • 文本形式打开文件:
1
2
3
tf = open('f.txt','rt')
print(tf.readline())
tf.close()
  • 二进制形式打开文件:
1
2
3
bf = open('f.txt','rb')
print(bf.readline())
bf.close()
  • 文件的打开和关闭:

    • 文件打开: = open (,)

    • 文件路径:用斜杠替代反斜杠,相对路径”./PYE/f.txt”

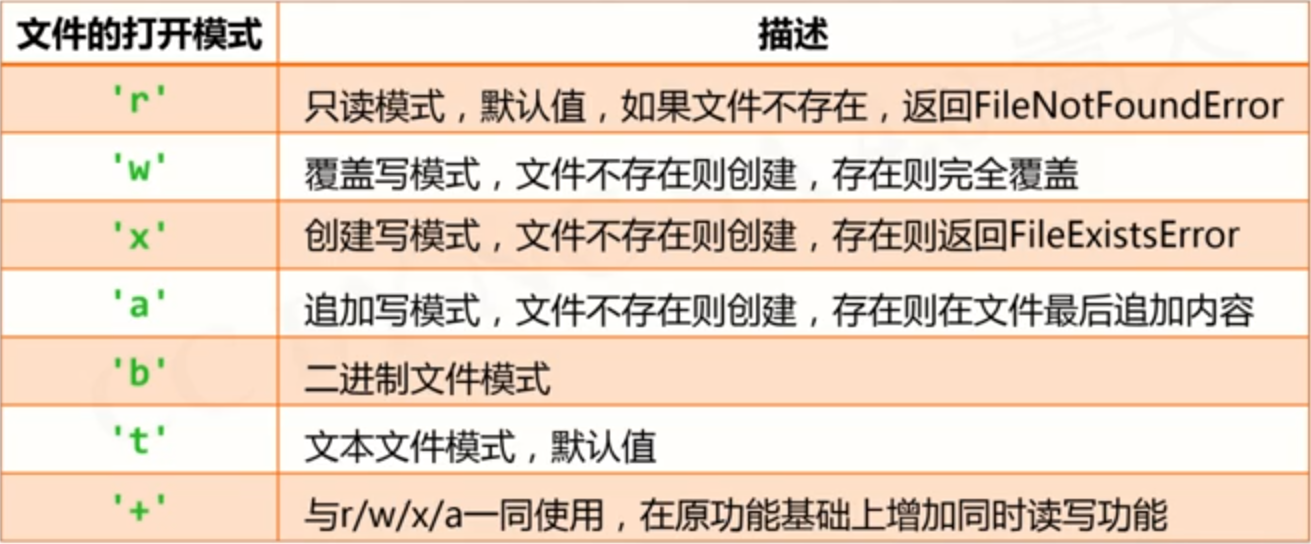
    • 文件打开模式:

      0ApkLR.png

    • 文件关闭:.close( )

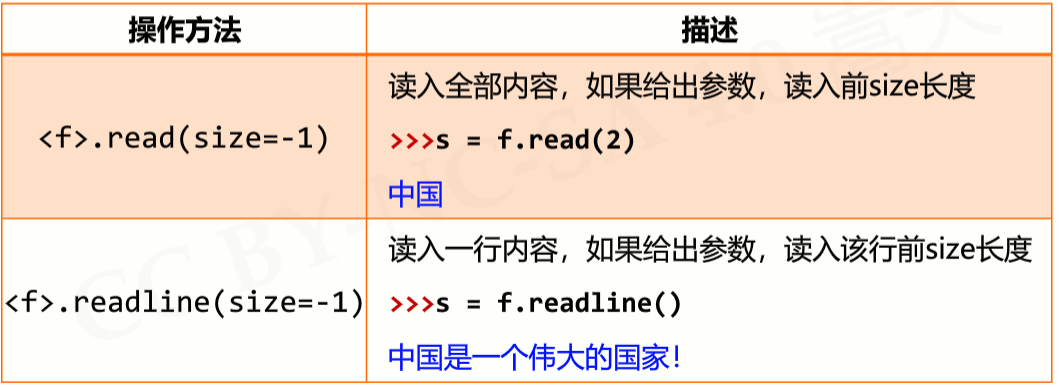
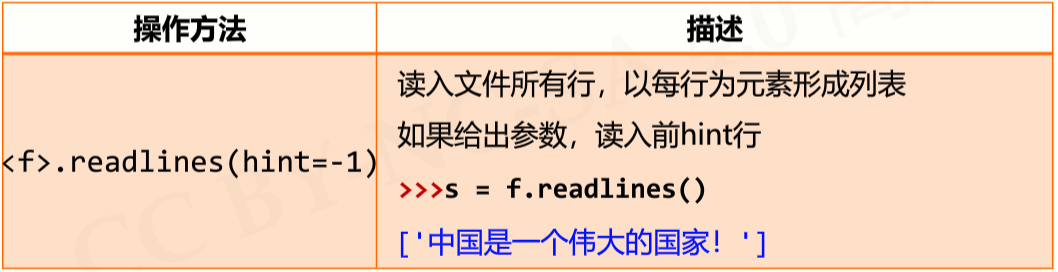
  • 文件内容的读取:

0ApiQJ.png
0ApCz4.png

  • 遍历全文本:
1
2
3
4
5
fname = input()
fo = open(fname,'r')
txt = fo.read()
#对全文txt进行处理
fo.close()

当文件较大时,读取会耗费大量资源

1
2
3
4
5
6
fname = input()
fo = open(fname,'r')
txt = fo.read()
while txt!="":
txt = fo.read(2)
fo.close()

逐行遍历:

1
2
3
4
5
6
7
8
9
10
11
12
13
# Solution 1
fname = input()
fo = open(fname,'r')
for line in fo.readlines():
print(line)
fo.close()

# Solution 2
fname = input()
fo = open(fname,'r')
for line in fo:
print(line)
fo.close()
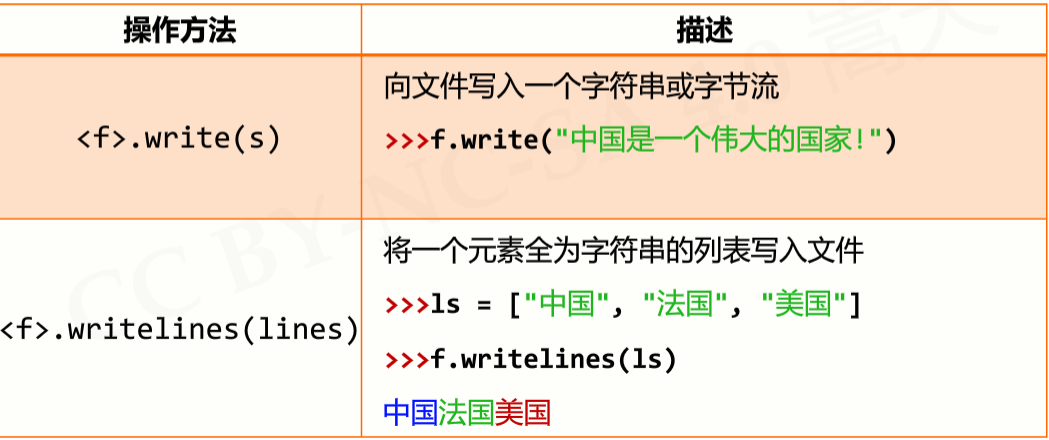
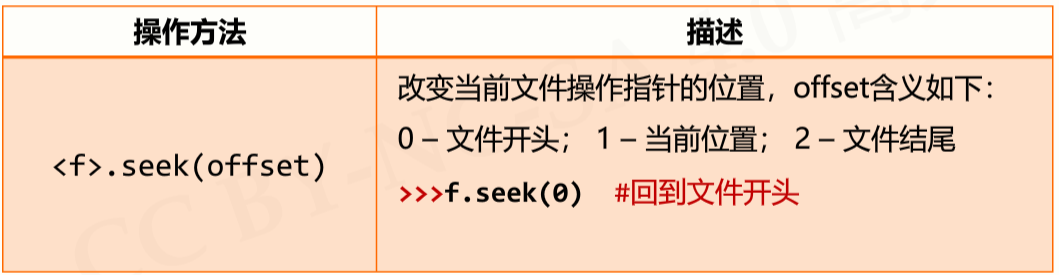
  • 数据的文件写入:

0AppJU.png
0Ap9WF.png

7.2 实例11:自动轨迹绘制

根据脚本来绘制图形

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
#AutoTraceDraw.py
import turtle as t
t.title('自动轨迹绘制')
t.setup(800, 600, 0, 0)
t.pencolor("red")
t.pensize(5)
#数据读取
datals = []
f = open("data.txt")
for line in f:
line = line.replace("\n","")
datals.append(list(map(eval, line.split(","))))
f.close()
#自动绘制
for i in range(len(datals)):
t.pencolor(datals[i][3],datals[i][4],datals[i][5])
t.fd(datals[i][0])
if datals[i][1]:
t.rt(datals[i][2])
else:
t.lt(datals[i][2])

map(, list var): 对列表中每一个元素执行map函数里第一个参数对应的函数操作

7.3 一维数据的格式化和处理

  • 一维数据:由对等关系的有序或无序数据构成。
  • 二维数据:由多个一维数据构成,是一维数据的组合形式
  • 多维数据:由一维或二维数据构成的一种扩展
  • 高维数据:仅利用最基本的二元关系展示数据间的复杂结构(键值对)
  • 一位数据的表示:
    • 如果数据间是无序的:使用集合类型
    • 有序的:列表类型
  • 一维数据的存储:
    • 把数据之间使用空格分隔,缺点:数据中不能存在空格
    • 存储方式二:逗号分隔
    • 存储方式三:其它方式(其它特殊符号)
  • 一维数据的处理:存储<->表示

读取数据

1
2
3
4
5
6
7
8
txt = open(fname).read()
ls = txt.split()
f.close()

# 特殊分隔符
txt = open(fname).read()
ls = txt.split('$')
f.close()

写入数据:

1
2
3
4
ls = ['China', 'US', 'Japan']
f = open(fname,'w')
f.write(' ',joint(ls))
f.close()

7.4 二维数据的格式化

  • 二维数据的表示:采用二维列表表达格式
  • 二维数据的读取:两层for循环来遍历数据
  • CSV数据存储格式
    • 国际通用的一二维数据存储格式,一般.csv扩展名
    • 每行一个一维数据,采用逗号分隔,无空行
    • Excel和一般编辑软件都可以读入或者另存为csv文件
  • CSV存储约定:
    • 如果某个元素缺失,逗号仍要保留
    • 二维数据的表头可以作为数据存储,也可以另行存储
    • 逗号为英文半角符号,逗号与数据之间无额外空格
    • 数据中包含逗号,使用在数据两侧增加引号等方法,或者增加转意符
  • 常规的索引习惯:ls[row][column],先行后列
  • 二维数据的读写
1
2
3
4
5
6
7
8
9
10
11
12
fo = open(fname)
ls = []
for line in fo:
line = line.replace('\n','')
ls.append(ls.split(','))
fo.close()

ls = [[],[],[]]
f = open(fname,'w')
for item in ls:
fwrite(','.join(item)+'\n')
f.close()

7.5 模块6:wordcloud库

  • wordcloud库是优秀的词云展示第三方库
  • w = wordvloud.WordCloud()
  • 词云的形状尺寸颜色都可以自定
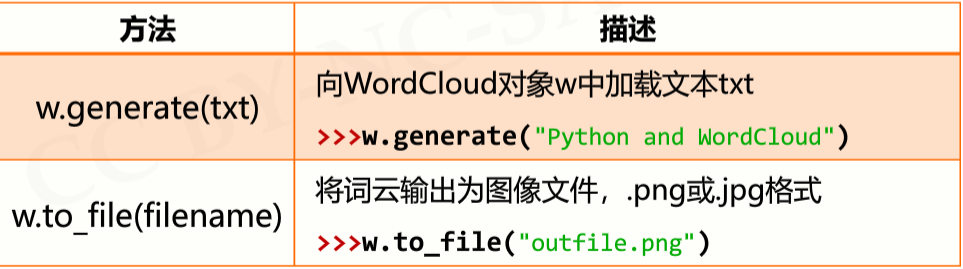
  • wordcloud库常规方法

0ApEe1.png

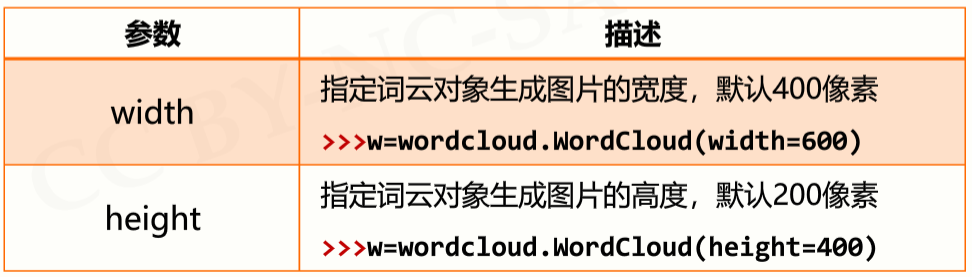
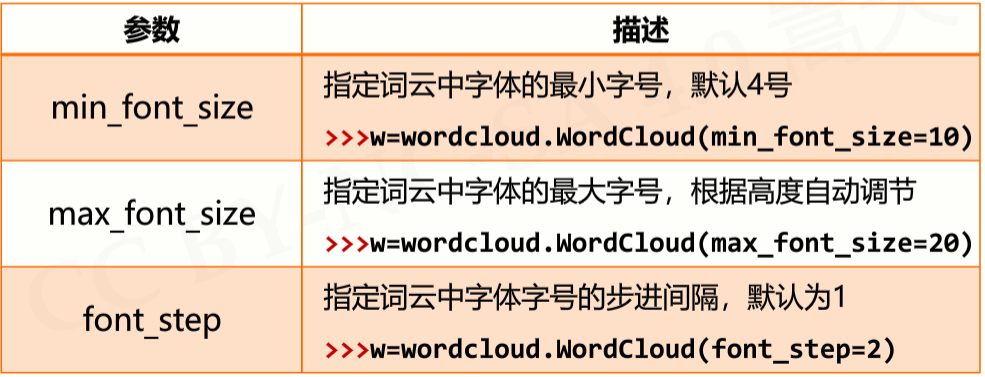
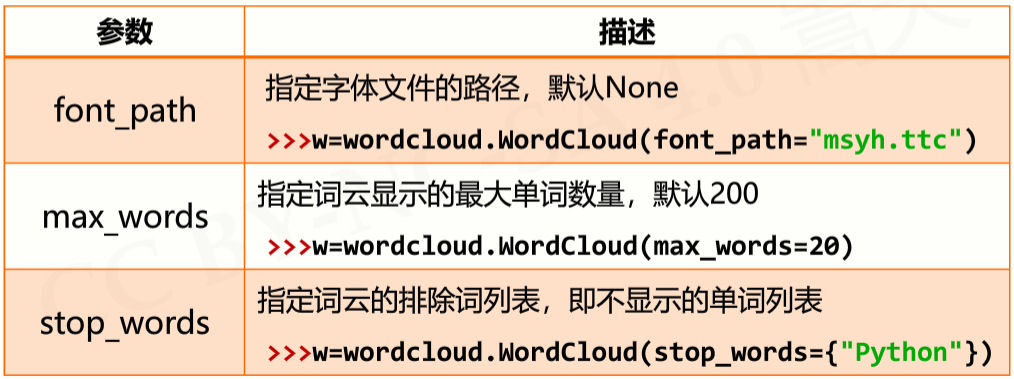
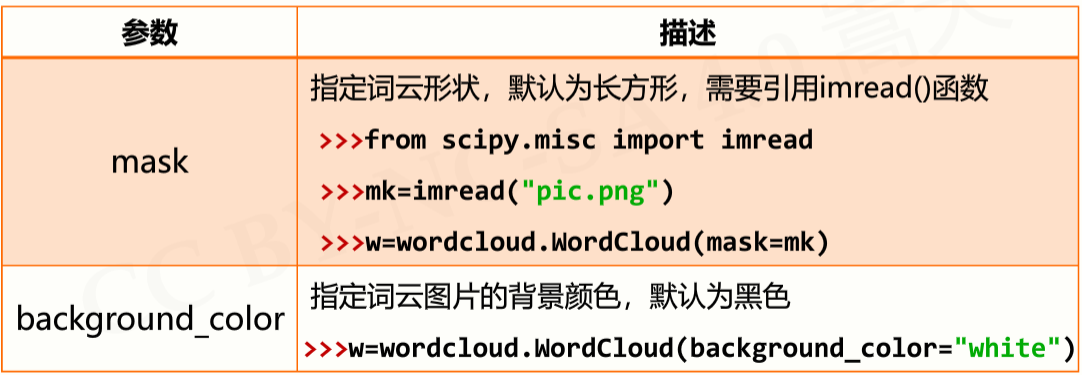
  • 配置对象参数:

0ApVdx.png
0ApZo6.png
0ApmFK.png
0ApnJO.png

7.6 实例12:政府工作报告词云

矩形词云:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
#GovRptWordCloudv1.py
import jieba
import wordcloud
f = open("新时代中国特色社会主义.txt", "r", encoding="utf-8")

t = f.read()
f.close()
ls = jieba.lcut(t)

txt = " ".join(ls)
w = wordcloud.WordCloud( \
width = 1000, height = 700,\
background_color = "white",
font_path = "msyh.ttc"
)
w.generate(txt)
w.to_file("grwordcloud.png")

不规则词云

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
#GovRptWordCloudv2.py
import jieba
import wordcloud
from scipy.misc import imread
mask = imread("chinamap.jpg")
excludes = { }
f = open("新时代中国特色社会主义.txt", "r", encoding="utf-8")
t = f.read()
f.close()
ls = jieba.lcut(t)
txt = " ".join(ls)
w = wordcloud.WordCloud(\
width = 1000, height = 700,\
background_color = "white",
font_path = "msyh.ttc", mask = mask
)
w.generate(txt)
w.to_file("grwordcloudm.png")

7.Practice

  • 文件行数:打印输出附件文件的有效行数,注意:空行不计算为有效行数。
1
2
3
4
5
6
7
8
f = open('latex.log','r',encoding='UTF-8')
count = 0
for line in f.readlines():
if line == '\n':
continue
else:
count += 1
print("共{}行".format(count))
  • 文件字符分布:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
fname = 'latex.log'
fo = open(fname,'r',encoding='UTF-8')

d = {}
# 给每个小写字母添加一个键,防止有个数为0的字母
for i in range(26):
d[chr(ord('a')+i)] = 0
wordcount = 0
for line in fo.readlines():
for char in line:
d[char] = d.get(char,0)+1
wordcount += 1 #统计字符数
print('共{}字符'.format(wordcount),end='')

for i in range(26):
if d[chr(ord('a')+i)]!=0:
print(f",{chr(ord('a')+i)}:{d[chr(ord('a')+i)]}",end='')
  • 文件独特行数:统计附件文件中与其他任何其他行都不同的行的数量,即独特行的数量。
1
2
3
4
5
6
7
8
fname = 'latex.log'
fo = open(fname,'r',encoding='UTF-8')
ls = fo.readlines()
s =set(ls)
for i in s:
ls.remove(i)
t = set(ls)
print("共{}独特行".format(len(s)-len(t)))
  • CSV格式列转换:附件是一个CSV文件,请将每行按照列逆序排列后输出,不改变各元素格式(如周围空格布局等)。
1
2
3
4
5
6
7
8
fname = 'data.csv'
fo = open(fname,'r')
for line in fo:
line = line.strip('\n')
ls = line.split(',')
ls = ls[::-1]
print(",".join(ls))
fo.close()
  • CSV格式数据清洗:

附件是一个CSV文件,其中每个数据前后存在空格,请对其进行清洗,要求如下:‪‬‪‬‪‬‪‬‪‬‮‬‫‬‪‬‪‬‪‬‪‬‪‬‪‬‮‬‫‬‪‬‪‬‪‬‪‬‪‬‪‬‮‬‫‬‫‬‪‬‪‬‪‬‪‬‪‬‮‬‫‬‮‬‪‬‪‬‪‬‪‬‪‬‮‬‭‬‪‬‪‬‪‬‪‬‪‬‪‬‮‬‭‬‪‬

(1)去掉每个数据前后空格,即数据之间仅用逗号(,)分割;‪‬‪‬‪‬‪‬‪‬‮‬‫‬‪‬‪‬‪‬‪‬‪‬‪‬‮‬‫‬‪‬‪‬‪‬‪‬‪‬‪‬‮‬‫‬‫‬‪‬‪‬‪‬‪‬‪‬‮‬‫‬‮‬‪‬‪‬‪‬‪‬‪‬‮‬‭‬‪‬‪‬‪‬‪‬‪‬‪‬‮‬‭‬‪‬

(2)清洗后打印输出。

1
2
3
4
5
f = open("data.csv")
s = f.read()
s = s.replace(" ","")
print(s)
f.close()