#CalStatisticsV1.py defgetNum():#获取用户不定长度的输入 nums = [] iNumStr = input("请输入数字(回车退出): ") while iNumStr != "": nums.append(eval(iNumStr)) iNumStr = input("请输入数字(回车退出): ") return nums defmean(numbers):#计算平均值 s = 0.0 for num in numbers: s = s + num return s / len(numbers) defdev(numbers, mean):#计算方差 sdev = 0.0 for num in numbers: sdev = sdev + (num - mean)**2 return pow(sdev / (len(numbers)-1), 0.5) defmedian(numbers):#计算中位数 sorted(numbers) size = len(numbers) if size % 2 == 0: med = (numbers[size//2-1] + numbers[size//2])/2 else: med = numbers[size//2] return med n = getNum() #主体函数 m = mean(n) print("平均值:{},方差:{:.2},中位数:{}.".format(m, dev(n,m),median(n)))
6.4 字典类型及操作
字典类型的定义:
映射:映射是一种键(索引)和值(数据)的对应
字典类型通过键值对建立索引
采用 { } 或 dict()创建,键值对用: 来表示
字典索引 [ ]
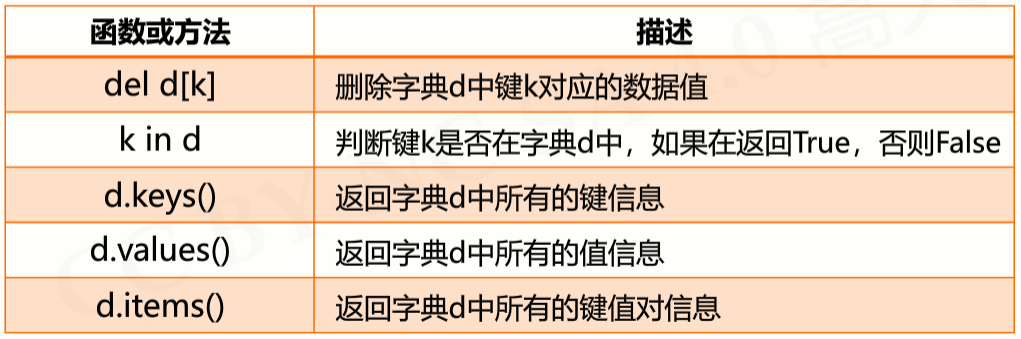
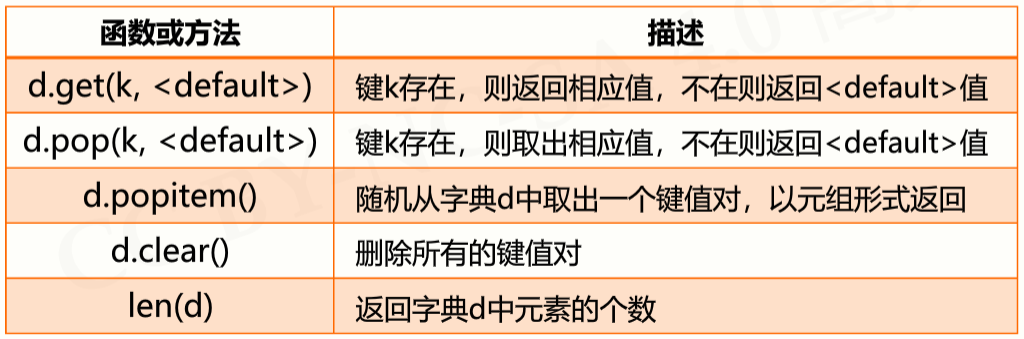
字典类型操作函数:
字典类型应用场景
映射的表达:统计数据出现次数
6.5 模块5:jieba库
jieba是优秀的中文分词第三方库
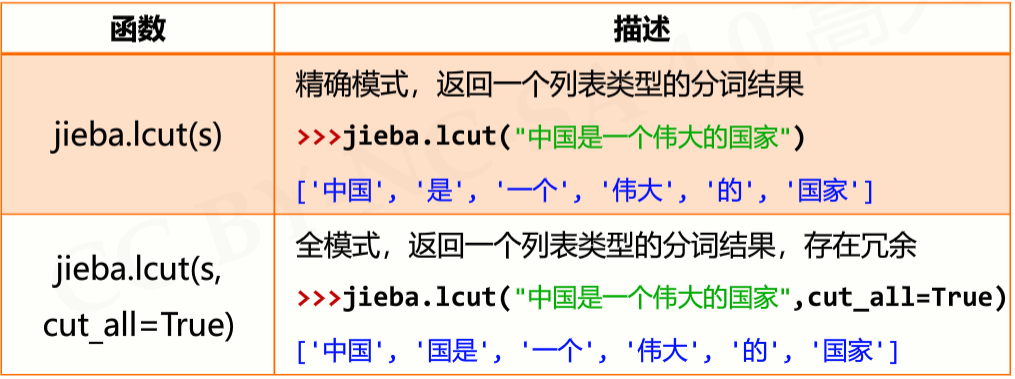
精确模式:把文本精确分开,不存在冗余单词
全模式:把文本中所有可能的词语都扫描出来,有冗余
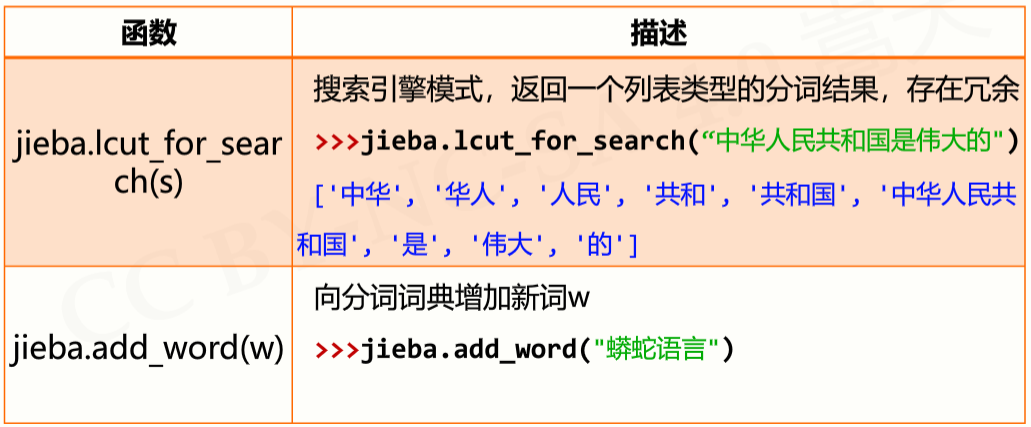
jieba库常用函数:
6.6 实例10:文本词频统计
《哈姆雷特》词频统计:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18
#CalHamletV1.py defgetText(): txt = open("hamlet.txt", "r").read() txt = txt.lower() for ch in'!"#$%&()*+,-./:;<=>?@[\\]^_‘{|}~': txt = txt.replace(ch, " ") #将文本中特殊字符替换为空格 return txt hamletTxt = getText() words = hamletTxt.split() counts = {} for word in words: counts[word] = counts.get(word,0) + 1 items = list(counts.items()) items.sort(key=lambda x:x[1], reverse=True) for i in range(10): word, count = items[i] print ("{0:<10}{1:>5}".format(word, count))
#CalThreeKingdomsV2.py import jieba excludes = {"将军","却说","荆州","二人","不可","不能","如此"} txt = open("threekingdoms.txt", "r", encoding='utf-8').read() words = jieba.lcut(txt) counts = {} for word in words: if len(word) == 1: continue elif word == "诸葛亮"or word == "孔明曰": rword = "孔明" elif word == "关公"or word == "云长": rword = "关羽" elif word == "玄德"or word == "玄德曰": rword = "刘备" elif word == "孟德"or word == "丞相": rword = "曹操" else: rword = word counts[rword] = counts.get(rword,0) + 1 for word in excludes: del counts[word] items = list(counts.items()) items.sort(key=lambda x:x[1], reverse=True) for i in range(10): word, count = items[i] print ("{0:<10}{1:>5}".format(word, count))
s = input() try: d = eval(s) e = {} for k in d: e[d[k]] = k print(e) except: print("输入错误")
《沉默的羔羊》之最多单词
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16
import jieba f = open("沉默的羔羊.txt") ls = jieba.lcut(f.read()) d = {} for w in ls: d[w] = d.get(w,0)+1 maxc = 0 maxw = "" for k in d: if d[k] > maxc and len(k) > 2: maxc = d[k] maxw = k if d[k] == maxc and len(k) > 2and k > maxw: maxw = k print(maxw) f.close()
数字不同数之和:获得用户输入的一个整数N,输出N中出现不同数字的和
输入:1231233213
输出:6
1
2
3
4
5
6
s = input()
ls = []
for num in s:
    ls.append(eval(num))
arr = set(ls)
print(sum(arr))